口播剪到一半,缺画面通常有两种原因。一种是人物连续说了很久,观众需要换口气。另一种是句子里提到一个地点、产品或操作,只有声音很难讲清楚。先分清是哪一种,后面的镜头才不会乱。
先从文字稿里找位置
打开文字稿,找到需要补画面的那句话。地点、操作步骤和抽象概念经常值得补,人物正在表达态度时可以多留一会儿正面画面。整条口播每隔几秒塞一段空镜,最后只会把注意力切碎。
把播放头停在句子附近,再看时间线上究竟空了多久。两三秒的缺口可以先用一张图。需要展示动作、环境变化或镜头推进时,再考虑生成视频。
在讲到夜景城市的这句话上方放一张竖版图片,原人声继续播放
图片先看构图,视频再看运动
图片模型适合先试构图。ChatCut Online 已接入 Seedream、GPT Image、Nano Banana 和 Wan 等图片模型。生成前会显示报价,确认以后才扣积分,任务失败会自动退回。
构图合适,但画面停着太僵,可以再做视频。Seedance 2.0 单段支持 4 到 15 秒,Seedance 2.5 单段支持 4 到 30 秒,也支持首帧与首尾帧图生视频。前一个镜头里已有合适画面时,拿它做参考图更容易接上。
回到时间线看衔接
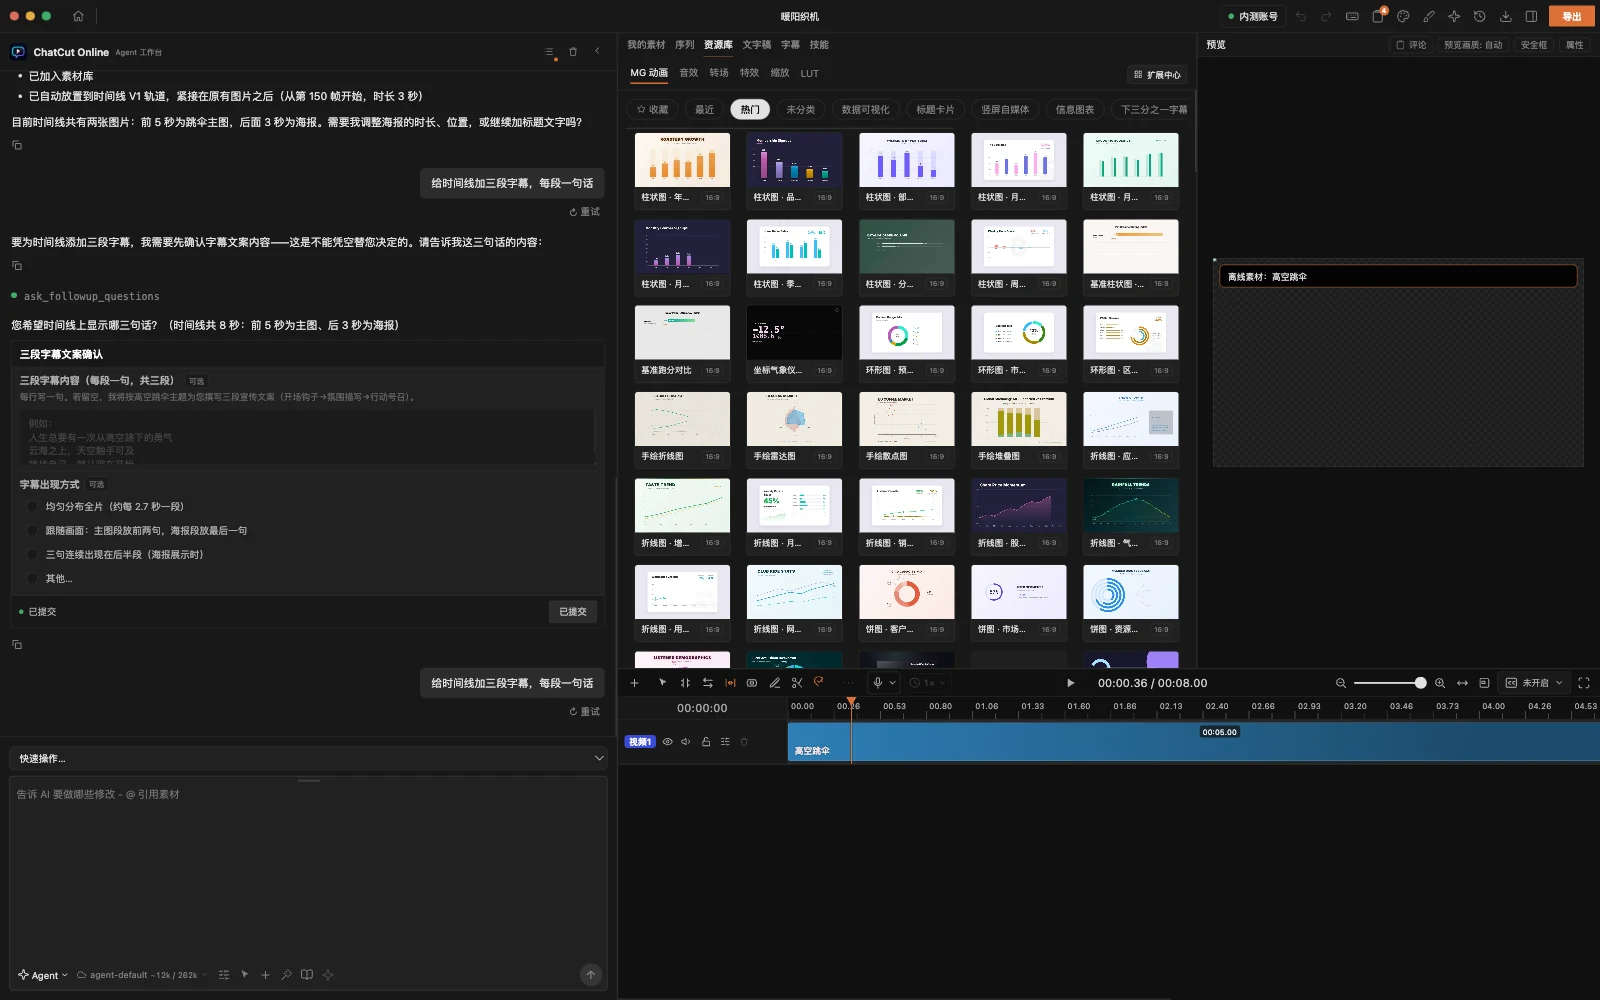
生成完成以后,要把镜头放到人物画面上方的视频轨。这样原人声能保持连续,补充画面也可以单独移动、缩短或替换。
检查时从前一个镜头多看两秒,再看到后一个镜头结束。光线突然从白天跳到夜晚,人物方向对不上,或者画幅与成片不一致,单看生成结果时都不容易发现。把镜头放回上下文,这些问题才会露出来。
发布前再核一遍事实
生成画面很适合空镜和示意。涉及具体人物、产品外观、地点与数字时,要逐项核对。参考图和提示词会经云端发送给对应模型,涉密素材不应拿去生成。
最后检查 AIGC 标识与平台要求。镜头能顺利放进时间线,只说明文件可用。它能不能随成片发布,还要由创作者判断。
继续看 AI 图片与视频生成 和 品牌营销场景,可以把模型、画幅与交付格式接着对一遍。
常见问题
B-roll 会盖掉原来的声音吗?
把补充画面放在人物画面上方的视频轨,原口播音频可以继续播放。素材自带声音时,再决定静音或降低音量。
一次可以生成多长的视频?
Seedance 2.0 单段支持 4 到 15 秒,Seedance 2.5 单段支持 4 到 30 秒。具体模型和报价以产品内显示为准。
AI 生成的画面可以直接发布吗?
仍要检查人物、文字、品牌、地点和事实是否准确。生成产物带 AIGC 标识,发布时还要遵守平台规则。