图片生成视频的关键不是把提示词写得很长,而是先确定参考图承担首帧还是首尾帧,再说清镜头运动、主体动作和画幅。 ChatCut Online 当前支持首帧、首尾帧图生视频,生成前先报价,确认后才扣积分;生成完成的片段可以进入真实时间线继续剪辑。
图生视频前要准备什么?
先检查参考图是否满足三个条件:主体清楚、构图与目标画幅接近、画面里没有不希望被延续的错误元素。图像本身含糊时,模型很难只靠一句提示稳定补全细节。
首帧图生视频适合从一张画面开始发展动作;首尾帧则适合已经确定起点和终点,希望中间形成连续变化的任务。两者都需要在生成后实际检查,不能把参考图当成逐像素不变的保证。
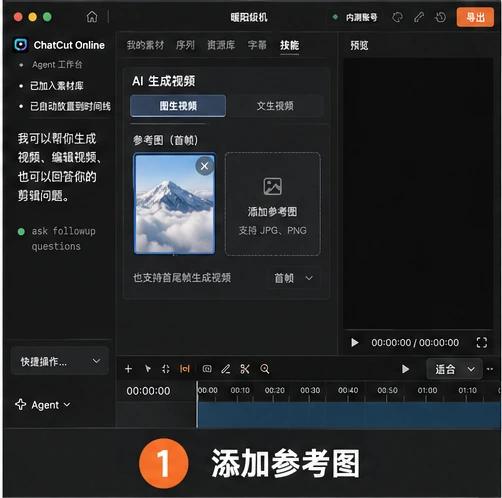
第一步:添加参考图
在 AI 视频生成入口添加参考图,并确认它作为首帧,或与另一张图片共同组成首尾帧。涉及人物、品牌商品或受版权保护的画面时,先确认你有权把素材发送给云端模型处理。
AI 生成时,提示词与参考图会发送给对应云端模型;这与本机转写“音频不上传”是不同的数据边界。具体存储与处理说明以产品内展示和 隐私政策 为准。
第二步:选择视频模型和时长范围
ChatCut Online 当前提供多种 Seedance 视频模型,包括 2.0 系列的 480p、720p 与 1080p 选项,以及 2.5 系列的 480p、720p 选项。Seedance 2.0 单段为 4 到 15 秒,2.5 单段为 4 到 30 秒;部分模型有版本档位要求,以生成面板当时显示为准。
模型名称、分辨率和时长是不同维度。不要只看分辨率选择,还要根据内容长度和可接受的生成范围判断。短镜头通常更适合把一个动作说清楚,再在时间线上组合。
第三步:根据发布位置设置画幅
当前支持 21:9、16:9、9:16、1:1、4:3 和 3:4。横版内容通常考虑 16:9,竖屏短视频常用 9:16,但最终仍要以发布位置和素材构图为准。
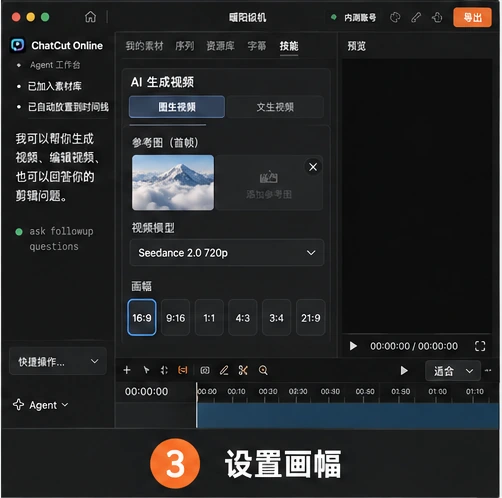
如果原图是横向构图,却直接生成 9:16,主体两侧内容可能无法完整保留。可以先重新准备适合竖屏的参考图,而不是把所有构图问题交给生成模型猜测。
第四步:怎样写视频描述?
一个可执行的描述可以按“镜头运动 + 主体动作 + 环境变化 + 保留项”组织:
镜头缓慢推近,云层轻轻移动,山峰位置保持稳定,不新增人物和文字。
只写“让它动起来”缺少方向;一次要求多个快速动作,又容易让短片失去重点。先生成一个明确动作,再决定是否继续做下一段,通常更便于在时间线上组合。
第五步:确认报价再生成
生成前,ChatCut Online 会先显示报价,用户确认后才扣积分;任务失败自动退回。不要在没有核对模型、画幅、参考图和描述时直接确认,因为成功生成但方向不符合预期,并不等同于任务失败。
建议确认前再看一遍:
- 参考图是否选对?
- 首帧与首尾帧模式是否符合任务?
- 模型和画幅是否匹配最终用途?
- 描述里是否只有一个主要动作?
- 是否删除了未授权或敏感素材?
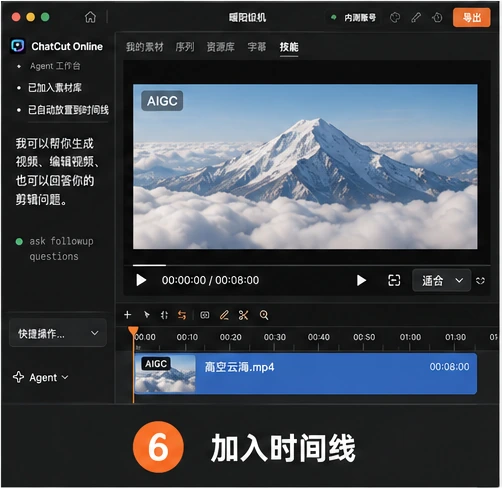
第六步:把生成片段加入时间线
生成完成后先预览整段,再放进视频轨。生成产物带 AIGC 标识,进入时间线后仍需检查开头、结尾、主体形态、画面连续性和与前后镜头的衔接。
口播里缺少补充镜头时,可继续阅读 怎样补一段 B-roll;如果需要先生成静态素材,产品支持的图片模型范围可在 AI 生成能力 查看。
图生视频验收清单
- 主体身份和主要形态是否保持可用?
- 镜头运动是否符合描述,没有突然跳变?
- 画幅是否适合最终发布位置?
- 首尾帧任务的起点和终点是否能够衔接?
- 是否出现多余人物、文字或物体?
- AIGC 标识和素材来源记录是否保留?
- 放进时间线后,是否与前后镜头连贯?
图生视频适合补充短镜头、分镜试验和视觉过渡,但最终可用性仍取决于参考图、描述、模型选择和人工验收。先把任务拆小,再逐段放回真实时间线,是更可控的制作方式。
常见问题
ChatCut Online 可以用图片生成视频吗?
可以。当前支持首帧图生视频和首尾帧图生视频,可选择已提供的视频模型与画幅。
图生视频支持哪些画幅?
当前支持 21:9、16:9、9:16、1:1、4:3 和 3:4。应根据最终发布位置和原图构图选择。
生成视频前会直接扣积分吗?
不会直接开始扣费。产品会在生成前先报价,用户确认后才扣积分;任务失败自动退回。
参考图会在本机处理吗?
AI 生成会把提示词与参考图发送给对应云端模型,生成产物带 AIGC 标识。不要上传无权使用或不应离开本机的敏感素材。