录口播最难受的部分在录完以后。回放一遍就会发现,自己每讲两句要停一下,中间还夹着一串「那个」「然后」。现场听不出来,做成视频以后特别明显。
这套流程适合什么素材
一个人对着镜头讲完一整段,中间不换机位,也不打算重新配音。素材是 MP4、MOV、WebM、MKV、AVI 里的任意一种,纯录音的 MP3、WAV、M4A 也走同一条路。做完要一条能直接发的成片,外加一份字幕文件。
第一步,导入以后等文字稿
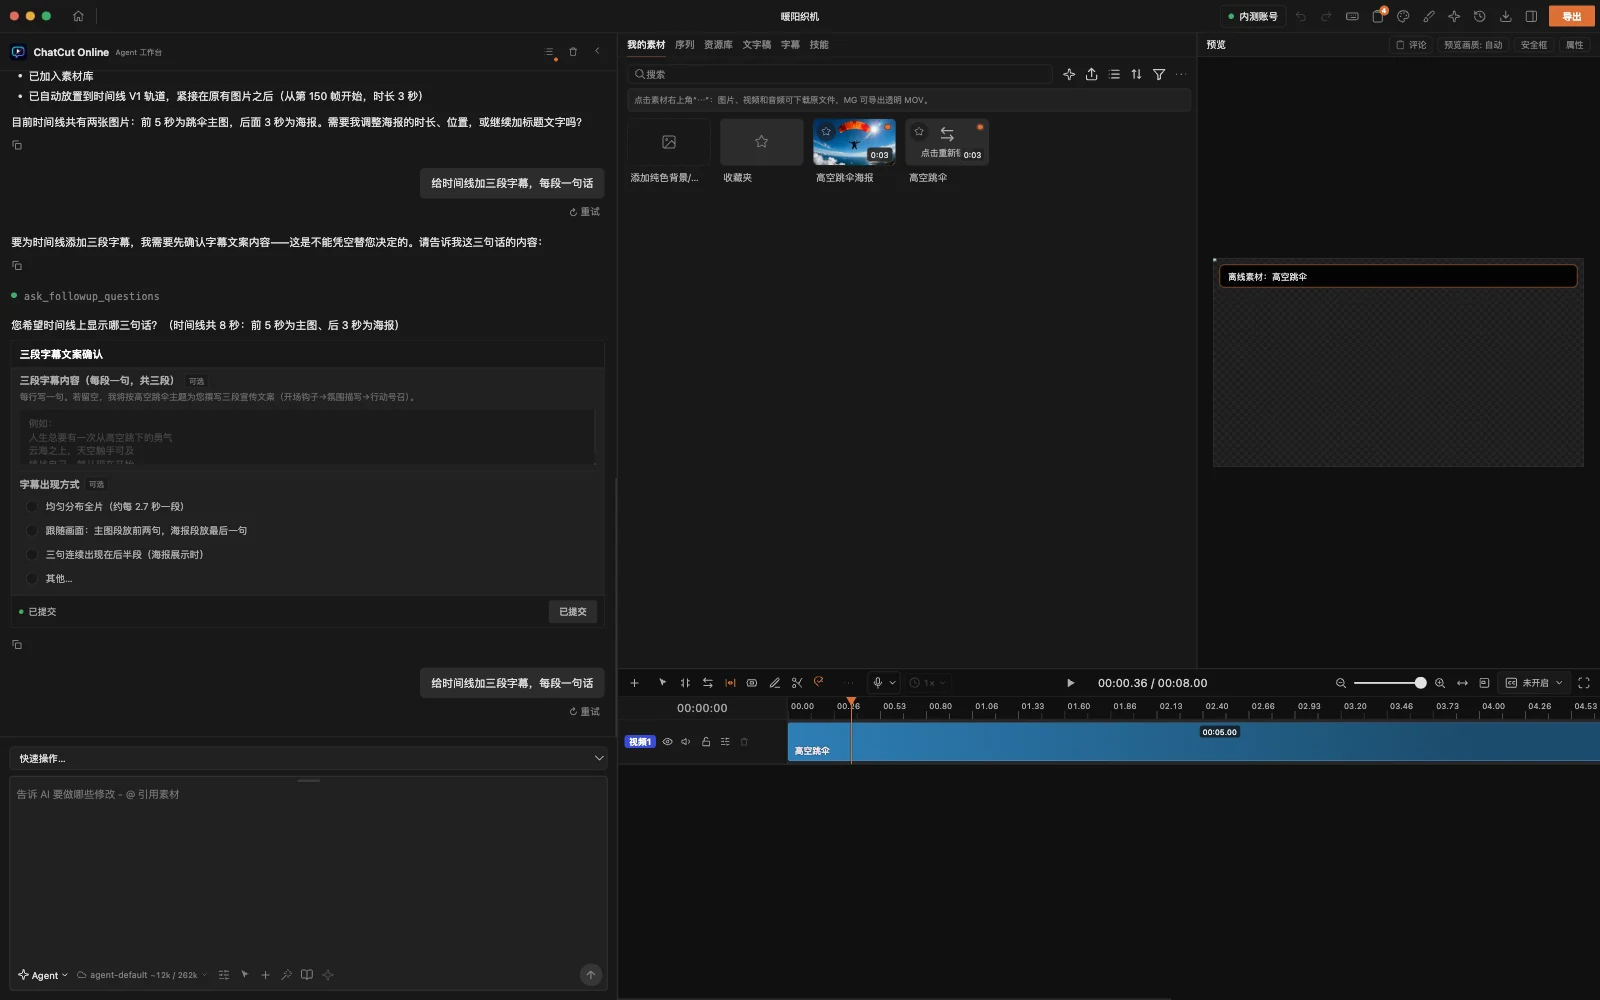
导入这一步得自己动手,把文件拖进「我的素材」,没有指令可下。素材一进来转写就自己开始了,跑在你这台机器上,音频不上传,中文、英语、日语、韩语、西班牙语、法语、德语、意大利语、俄语这九种语言都认得。
文字稿出来之前不用急着发指令。后面每一步都靠它定位,文字稿没好,说什么都落不到具体位置。
第二步,把停顿和口癖清掉
第一句指令可以直接说。
去掉停顿和口癖
Agent 会照着文字稿找到这些词,在时间线上把对应的那一小段裁掉。裁完轨道上会多出不少切口,属于正常现象,中间被删掉的部分本来就得把片段一分为二。
清完再听一遍,句子之间往往还留着很长的空。挑一处说。
把这段静音压到 0.3 秒
0.3 秒左右听着像正常换气。压到没有,两句话会黏在一起,反而更累。
第三步,加字幕并把样式定下来
给整条视频加逐字字幕
字幕跟着文字稿走,时间点已经对好了,不用手动打轴。样式再单独说一句。
把字幕换成描边白字放在下三分之一
下三分之一是各家平台按钮最少的一条带。描边白字在浅色和深色画面上都还能看清,省得为每条片子重新试颜色。
第四步,导出
成片走 MP4,最高到 4K。字幕文件另外要一份。
把这段导出成 SRT
平台自己有字幕系统的时候,SRT 比烧在画面上的字幕好改。想要纯文本就换成 TXT。要接着在别的软件里做后期,还可以出 FCPXML 或者整个工程包。
导出之前把整条从头看一遍。清完停顿的时间线会碎成很多小段,个别切口上画面会跳一下,看到了就把那一处的切点往前后挪一点再导。
注意事项
口癖别清得一个不剩。全清完人会听着像在念稿,留一两个反而自然。
人名、品牌名和专业词,转写不一定写对。客户端没有自定义词表这类东西,导出前把字幕从头看一遍,错的地方自己改。
同一句话重录了两遍的地方,先自己听一遍挑定哪条,再让它把另一条删掉。你比谁都清楚哪一遍的语气对。
转写要等它跑完再动手。半小时以上的原片,转写本身要花一会儿,这段时间发指令,Agent 手里的文字稿还是残的,定位自然也不准。
导出的成片和素材落在本机的素材目录,工程和聊天记录存在本机数据库。换台电脑接着剪,得自己把工程包带过去。